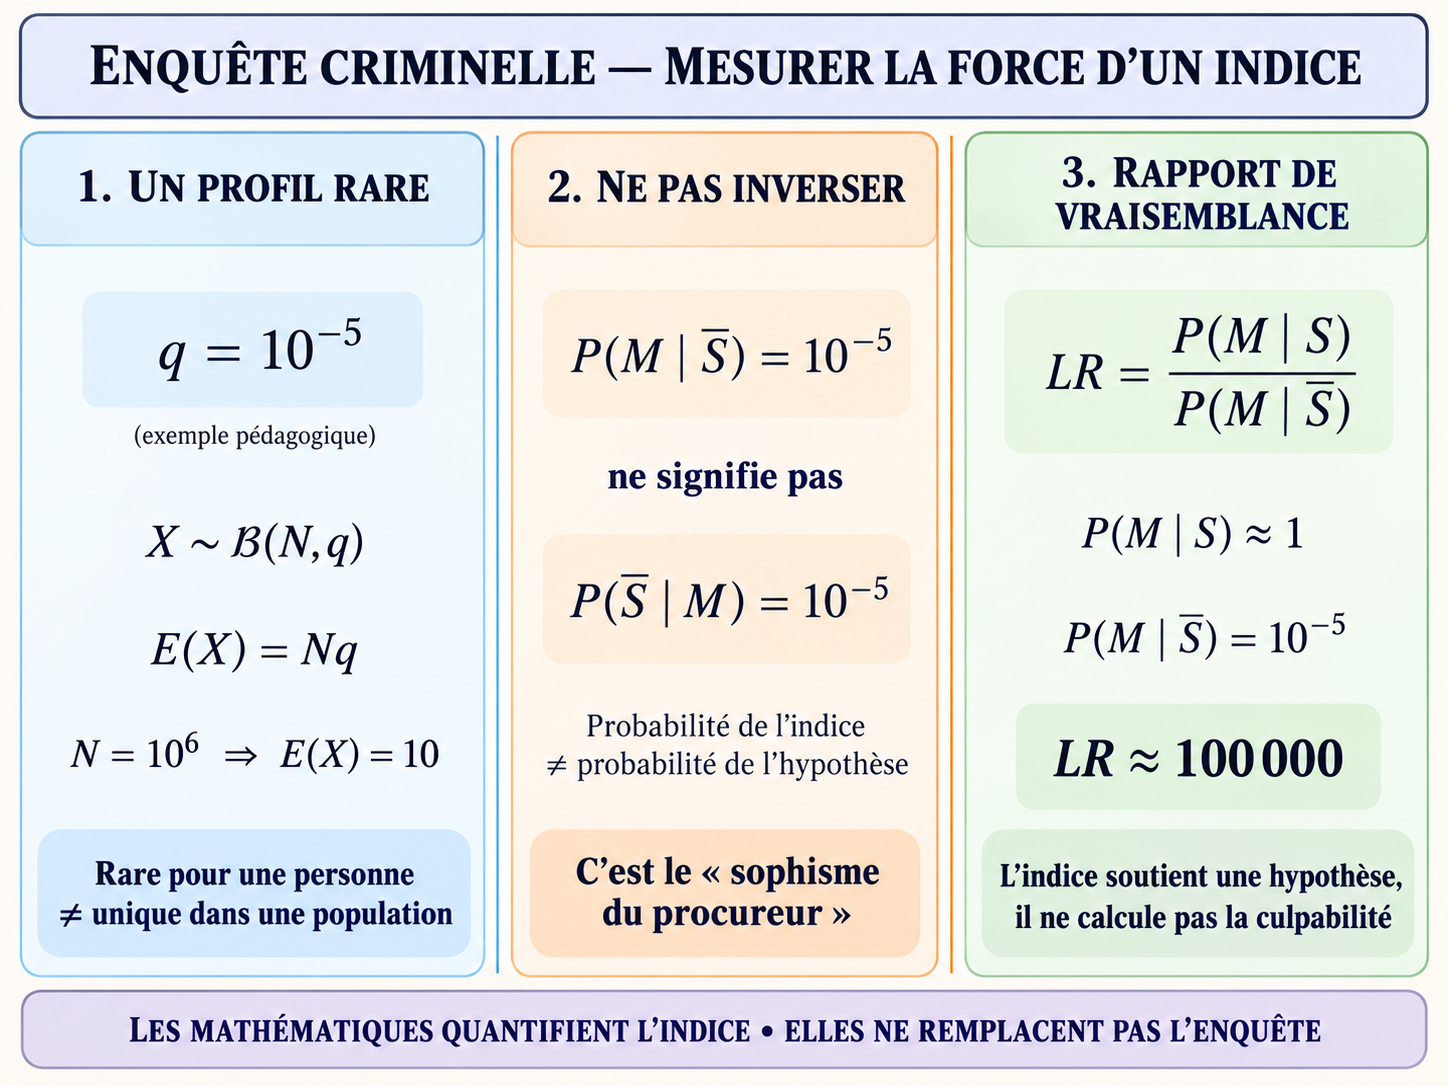
Exposé complet — objectif 10 minutes
0:00 → 1:00
Introduction — une correspondance ADN suffit-elle à désigner un coupable ?
Dans les séries policières, une correspondance ADN est parfois présentée comme une conclusion : « le profil correspond, donc nous avons trouvé le coupable ». Mathématiquement, le raisonnement est beaucoup plus subtil. Un profil génétique peut constituer un indice extrêmement fort, mais il faut distinguer la probabilité d’observer cet indice sous différentes hypothèses de la probabilité qu’une personne soit coupable.
Ma problématique est donc : en quoi les mathématiques permettent-elles l’avancée d’une enquête criminelle, et comment peuvent-elles mesurer la force d’un indice sans le transformer abusivement en preuve de culpabilité ?
Je vais me concentrer sur un exemple ADN simplifié, car il permet de mobiliser probabilités conditionnelles, loi binomiale et raisonnement bayésien. J’évoquerai ensuite ce que les mathématiques peuvent réellement apporter à l’enquête.
1:00 → 2:20
1. Un profil rare n’est pas forcément unique
Je note \(M\) l’événement « le profil génétique observé sur la trace correspond au profil de la personne testée ». Je suppose, dans un exemple purement pédagogique, que pour une personne qui n’est pas la source de la trace, la probabilité d’une correspondance vaut
\[
q=10^{-5}.
\]
Cela signifie une chance sur cent mille pour une personne non-source choisie selon le modèle.
Une erreur intuitive consiste à entendre « une chance sur cent mille » et à penser immédiatement « il n’y a pratiquement personne d’autre ». Mais la taille de la population compte.
Supposons que l’on considère \(N=1\,000\,000\) personnes et, pour simplifier, que les correspondances soient indépendantes et de même probabilité \(q\). Si \(X\) désigne le nombre de personnes non-sources qui correspondent au profil, alors
\[
X\sim\mathcal B(N,q)
\]
et
\[
E(X)=Nq.
\]
Donc
\[
\boxed{E(X)=1\,000\,000\times10^{-5}=10}.
\]
Attention : cela ne signifie pas qu’il y aura exactement dix personnes. C’est une espérance. Mais cela suffit à montrer qu’un événement très rare à l’échelle individuelle peut produire plusieurs correspondances lorsqu’on recherche dans une grande population.
2:20 → 3:35
2. La loi binomiale mesure aussi le risque d’au moins une correspondance fortuite
Dans le même modèle, la probabilité qu’aucune des \(N\) personnes non-sources ne corresponde vaut
\[
(1-q)^N.
\]
La probabilité d’obtenir au moins une correspondance fortuite est donc
\[
\boxed{1-(1-q)^N}.
\]
Avec \(q=10^{-5}\) et \(N=10^6\),
\[
1-(1-10^{-5})^{10^6}\approx0{,}99995.
\]
Dans ce modèle très simplifié, il serait donc presque certain d’obtenir au moins une correspondance fortuite si l’on testait un million de personnes.
Ce calcul ne décrit pas directement le fonctionnement réel d’une base ADN : il sert à mettre en évidence un principe mathématique. Une fréquence faible doit toujours être interprétée avec le nombre de comparaisons effectuées et avec les hypothèses du modèle.
3:35 → 5:15
3. Le piège majeur : inverser une probabilité conditionnelle
Je note maintenant \(S\) l’hypothèse « la personne testée est la source de la trace ». Le nombre \(10^{-5}\) représente dans notre exemple
\[
P(M\mid\overline S),
\]
c’est-à-dire la probabilité d’observer une correspondance si la personne n’est pas la source.
Mais la question que l’enquêteur aimerait connaître est plutôt
\[
P(S\mid M),
\]
la probabilité que la personne soit la source sachant qu’il y a correspondance.
Ces deux probabilités ne sont pas égales :
\[
\boxed{P(M\mid\overline S)\neq P(\overline S\mid M)}.
\]
Confondre les deux est ce que l’on appelle le sophisme du procureur. Dire « une personne qui n’est pas la source n’aurait qu’une chance sur cent mille de correspondre » ne permet pas de conclure « il y a une chance sur cent mille que la personne ne soit pas la source ».
La première quantité mesure la probabilité de l’indice sous une hypothèse. La seconde concerne la probabilité de l’hypothèse après avoir observé l’indice. Pour passer de l’une à l’autre, il faut tenir compte du contexte initial.
5:15 → 6:50
4. Un modèle de Bayes montre pourquoi le contexte est indispensable
Prenons un modèle volontairement artificiel mais très instructif : imaginons qu’avant l’analyse ADN, une personne ait été choisie au hasard parmi un million de personnes toutes considérées comme également plausibles pour être la source. Alors
\[
P(S)=10^{-6}.
\]
Supposons aussi, pour simplifier, que si cette personne est effectivement la source, la correspondance soit certaine :
\[
P(M\mid S)=1.
\]
La formule des probabilités conditionnelles donne
\[
P(S\mid M)
=
\frac{P(M\mid S)P(S)}
{P(M\mid S)P(S)+P(M\mid\overline S)P(\overline S)}.
\]
En remplaçant,
\[
P(S\mid M)
=
\frac{10^{-6}}
{10^{-6}+10^{-5}(1-10^{-6})}
\approx0{,}091.
\]
Donc, dans ce modèle très particulier, une correspondance pourtant rare ne conduirait qu’à environ 9 % de probabilité que la personne soit la source. Ce chiffre n’est évidemment pas une règle judiciaire : il dépend entièrement de notre hypothèse initiale, ici le choix au hasard parmi un million de personnes.
Si d’autres éléments indépendants avaient déjà réduit sérieusement le nombre de sources plausibles avant l’analyse ADN, la même correspondance aurait un poids beaucoup plus important. Les probabilités montrent donc que la valeur d’un indice dépend du contexte dans lequel il est interprété.
6:50 → 8:15
5. Le rapport de vraisemblance : comparer deux hypothèses
En science forensique, une manière rigoureuse d’exprimer la force d’observations consiste à comparer leur probabilité sous deux propositions. Dans notre exemple simplifié, on peut définir
\[
LR=
\frac{P(M\mid S)}
{P(M\mid\overline S)}.
\]
Avec
\[
P(M\mid S)\approx1
\qquad\text{et}\qquad
P(M\mid\overline S)=10^{-5},
\]
on obtient
\[
\boxed{LR\approx100\,000}.
\]
La bonne interprétation est : la correspondance observée est environ cent mille fois plus probable si la personne est la source de la trace que si elle ne l’est pas, dans notre modèle.
Cette formulation est très différente de « la personne a 99,999 % de chances d’être coupable ». Le rapport de vraisemblance compare deux explications de l’indice ; il ne calcule pas directement la probabilité de culpabilité.
Et même « être la source de l’ADN » n’est pas équivalent à « avoir commis le crime ». Une trace peut avoir été déposée auparavant, transférée indirectement ou être interprétée dans un contexte plus complexe. C’est pour cela que les experts distinguent la probabilité des observations de la probabilité des propositions judiciaires.
8:15 → 9:15
6. Les mathématiques ne se limitent pas à l’ADN
Une enquête peut mobiliser d’autres modèles mathématiques. La géométrie peut intervenir pour croiser des distances ou des directions et restreindre une zone de localisation. Des modèles d’évolution exponentielle ou différentielle peuvent intervenir dans certaines estimations temporelles, à condition d’énoncer leurs hypothèses. Les statistiques servent aussi à évaluer l’incertitude des mesures et les taux d’erreur de méthodes d’analyse.
Mais le même principe doit rester présent : un modèle mathématique n’est utile que si ses hypothèses sont justifiées. Deux indices ne peuvent pas forcément être multipliés comme s’ils étaient indépendants. Une mesure peut être contaminée. Une population de référence peut être mal choisie. Une trace biologique peut avoir plusieurs explications possibles.
Les mathématiques rendent donc l’enquête plus quantitative, mais elles obligent surtout à expliciter ce que l’on suppose.
9:15 → 10:00
Conclusion — les mathématiques évaluent un indice, elles ne prononcent pas un verdict
Je peux maintenant répondre à ma problématique. Les mathématiques font avancer une enquête en permettant de mesurer la rareté d’une observation, d’estimer le nombre de correspondances possibles, de comparer plusieurs hypothèses et de quantifier la force d’un indice.
Les probabilités conditionnelles montrent surtout qu’il faut résister à une confusion très intuitive : la probabilité d’observer un indice sous une hypothèse n’est pas la probabilité de cette hypothèse après observation de l’indice.
La conclusion essentielle est donc :
\[
\boxed{\text{un indice très fort n’est pas, à lui seul, une probabilité de culpabilité}.}
\]
Les mathématiques aident à raisonner plus rigoureusement ; elles ne remplacent ni les autres éléments de l’enquête, ni l’interprétation scientifique, ni la décision judiciaire.
Calibration : environ 1125 mots hors formules. Les calculs, les distinctions de probabilités et l’utilisation du support permettent d’atteindre naturellement les dix minutes.
15 questions possibles du jury — avec réponses
1. Pourquoi avez-vous choisi \(10^{-5}\) ?
C’est une valeur purement illustrative choisie pour rendre les calculs lisibles. Elle ne représente pas une fréquence universelle des profils ADN réels.
2. Pourquoi le nombre moyen de correspondances vaut-il \(Nq\) ?
Dans le modèle binomial \(X\sim\mathcal B(N,q)\), l’espérance vaut \(E(X)=Nq\).
3. Dire que l’espérance vaut 10 signifie-t-il qu’il y aura exactement 10 correspondances ?
Non. L’espérance est une moyenne théorique sur de nombreuses répétitions du modèle, pas une valeur garantie.
4. Pourquoi utilisez-vous une loi binomiale ?
Parce que le modèle suppose \(N\) comparaisons indépendantes avec la même probabilité \(q\) de correspondance fortuite.
5. Quelle est la probabilité d’au moins une fausse correspondance ?
Dans le modèle, elle vaut \(1-(1-q)^N\), complémentaire de l’événement « aucune correspondance ».
6. Quelle différence entre \(P(M\mid\overline S)\) et \(P(\overline S\mid M)\) ?
La première est la probabilité de la correspondance si la personne n’est pas la source ; la seconde est la probabilité qu’elle ne soit pas la source sachant qu’il y a correspondance.
7. Qu’est-ce que le sophisme du procureur ?
C’est la confusion entre la probabilité de l’indice sous une hypothèse et la probabilité de cette hypothèse après observation de l’indice.
8. Pourquoi avez-vous utilisé Bayes ?
Pour montrer que la probabilité après observation dépend à la fois de la force de l’indice et de la probabilité initiale de l’hypothèse.
9. Le résultat de 9 % signifie-t-il qu’une correspondance ADN ne vaut presque rien ?
Non. Ce 9 % appartient à un exemple artificiel où la personne est choisie au hasard parmi un million de sources équiprobables. Changer le contexte initial change complètement le résultat.
10. Qu’est-ce qu’un rapport de vraisemblance ?
C’est le rapport des probabilités d’observer les résultats sous deux propositions concurrentes. Il mesure à quel point les observations favorisent l’une par rapport à l’autre.
11. Que signifie ici un LR de 100 000 ?
Que la correspondance observée est cent mille fois plus probable sous l’hypothèse « la personne est la source » que sous l’hypothèse alternative du modèle.
12. Un LR de 100 000 signifie-t-il 99,999 % de culpabilité ?
Non. Le LR compare les probabilités de l’indice sous deux hypothèses. Il n’est pas une probabilité de culpabilité.
13. Être la source d’une trace ADN signifie-t-il avoir commis le crime ?
Non. La présence d’ADN peut avoir plusieurs explications : dépôt antérieur, transfert, contexte légitime, contamination ou autres mécanismes.
14. Peut-on multiplier les forces de deux indices ?
Seulement si la modélisation de leur dépendance le permet. Les multiplier naïvement en supposant une indépendance injustifiée peut produire une conclusion erronée.
15. À quoi servent alors les mathématiques dans une enquête ?
À quantifier l’incertitude, comparer des hypothèses, tester la cohérence d’un raisonnement et éviter certaines erreurs intuitives.