Exposé complet — environ 10 minutes
Une trame orale à comprendre et à s’approprier. Les démonstrations sont proposées pour être présentées progressivement devant le jury.
00:00–01:00Une image mutilée, une information encore lisible
Sur un ticket, une affiche ou un colis, il suffit parfois de scanner un QR code pour retrouver une adresse ou une information. Plus surprenant : le carré noir et blanc peut être rayé, sali ou partiellement masqué et être tout de même reconnu. Comment la machine peut-elle retrouver ce qui a disparu ? Le QR code contient plus que le message brut. Une partie des données permet de détecter ou de corriger des erreurs. Je vais d’abord construire moi-même un minuscule système de correction que l’on peut expliquer avec les mathématiques du lycée, puis préciser ce qui change dans un vrai QR code. Le sujet touche à une question essentielle : comment rendre l’information fiable sans supprimer totalement le risque d’erreur ?
01:00–02:00Des messages faits de zéros et de uns
Une machine représente l’information par des bits : des symboles ne pouvant prendre que deux valeurs, 0 ou 1. Imaginons que je veuille envoyer les quatre bits \(1011\). Ils ne disent rien à eux seuls sur leur fiabilité. Si le troisième bit est remplacé par un zéro, le message reçu pourrait être différent et rien ne permettrait de le deviner. Un premier réflexe consiste à ajouter un bit de parité : on choisit sa valeur pour que le nombre total de bits à 1 soit pair. Par exemple, \(1011\) contient trois uns ; j’ajoute donc un 1 et transmets \(10111\). Si un bit change, la parité devient impaire et le récepteur sait qu’une erreur s’est produite.
02:00–03:00Détecter n’est pas corriger
La parité seule ne dit pas quel bit est faux. Lorsque je reçois une série de longueur cinq ayant une parité incorrecte, j’ai plusieurs positions possibles pour l’erreur. Si deux bits changent, le nombre total de uns peut même redevenir pair : l’erreur échappe alors au contrôle. Pour corriger une erreur, il faut davantage d’informations que le simple fait « il y a quelque chose qui ne va pas ». L’idée mathématique est de fabriquer plusieurs contrôles qui observent des groupes différents de positions. Chaque position aura alors une sorte d’adresse codée par le résultat de ces contrôles. Nous allons fabriquer un message de sept bits à partir de quatre bits utiles : c’est le principe du code de Hamming (7,4).
03:00–04:00Placer les sept bits
Nous numérotions les positions de 1 à 7. Les données utiles occupent les places 3, 5, 6 et 7 ; les places 1, 2 et 4 sont réservées aux bits de contrôle. Pourquoi précisément ces positions ? Parce que 1, 2 et 4 sont les puissances de deux qui permettent de repérer toutes les autres positions en écriture binaire. Le premier contrôle porte sur les cases \(1,3,5,7\), le deuxième sur \(2,3,6,7\), le troisième sur \(4,5,6,7\). On impose une parité paire dans chacun de ces trois groupes. Pour quatre bits utiles, on ajoute donc trois bits de contrôle : sept bits seront transmis au lieu de quatre. Cette redondance n’est pas du gaspillage, c’est une assurance contre les erreurs.
04:00–05:00Un exemple entièrement calculable devant le jury
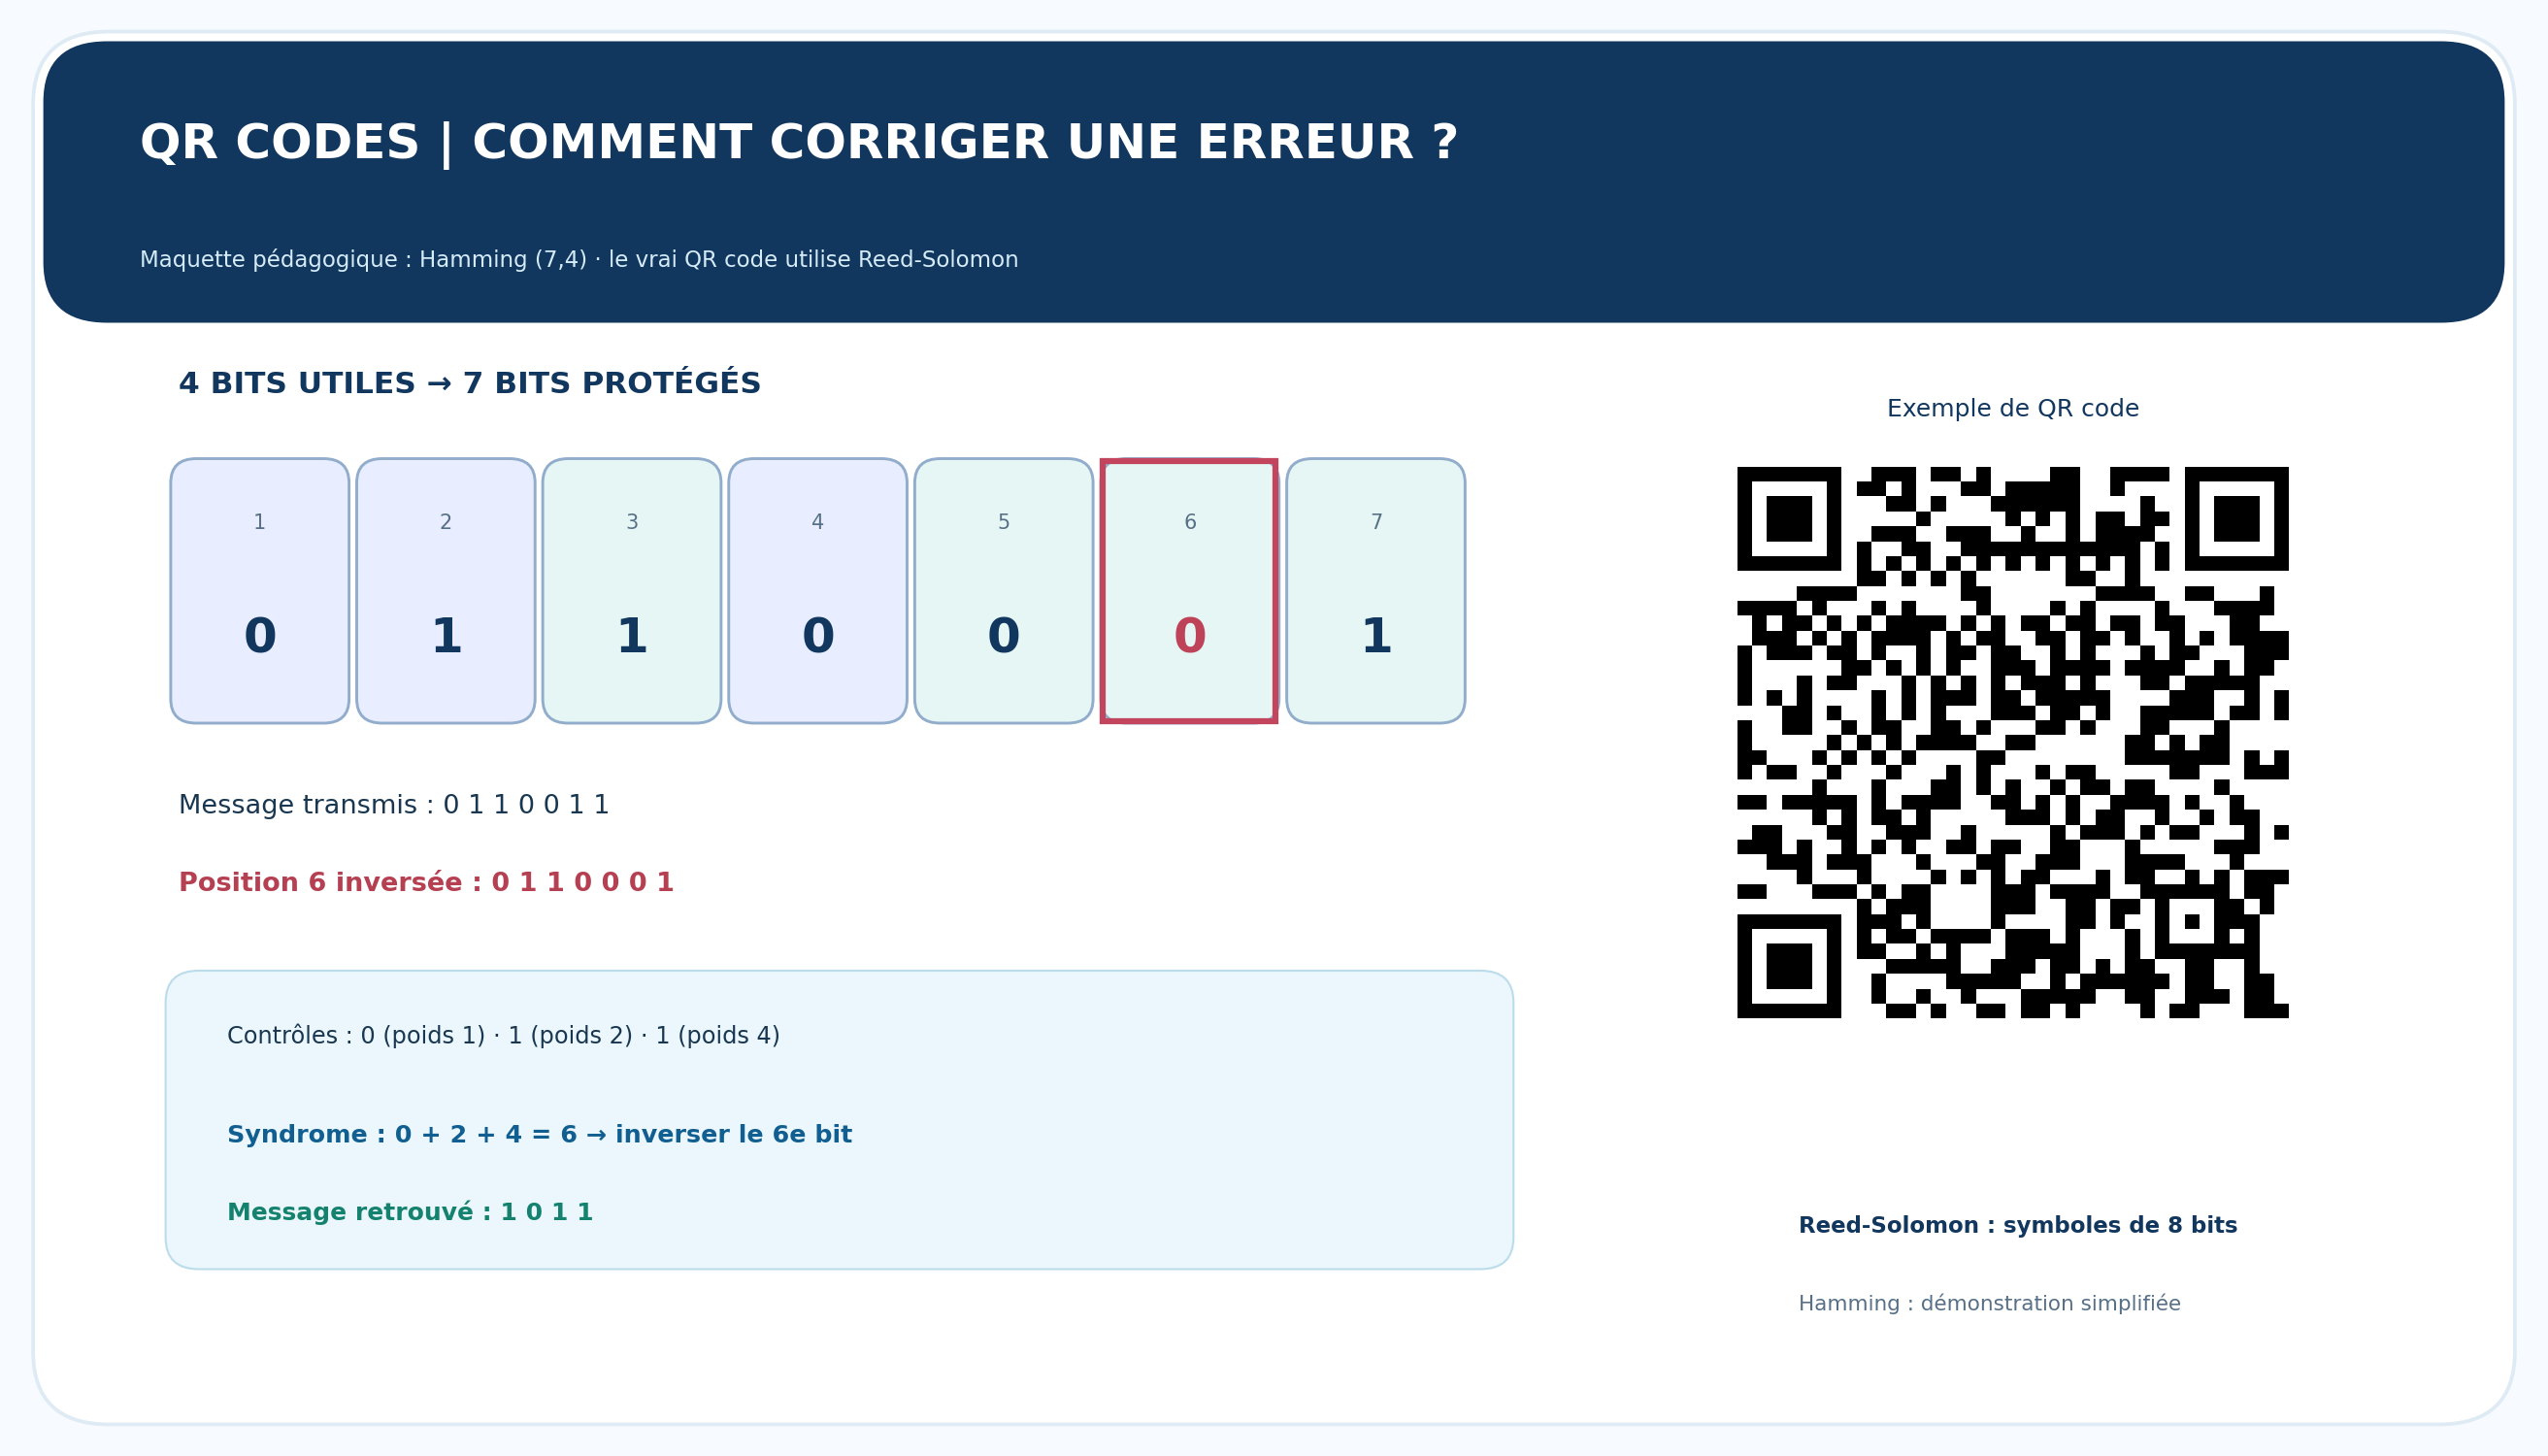
Prenons les données \(1011\). Nous les plaçons aux positions 3, 5, 6 et 7 : respectivement 1, 0, 1, 1. Dans le groupe des positions 1, 3, 5 et 7, on compte deux uns parmi les données : le premier bit de parité vaut donc 0. Dans le groupe 2, 3, 6 et 7, on compte trois uns : le deuxième bit vaut 1. Dans le groupe 4, 5, 6 et 7, il y a deux uns : le troisième bit vaut 0. Le message complet est ainsi \[\boxed{0110011}.\] On peut vérifier une à une les trois parités. Les trois bits supplémentaires n’ont pas le rôle de répéter le message : ils le rendent vérifiable et corrigeable.
05:00–06:00Une erreur, et son adresse apparaît
Supposons maintenant que la position 6 soit inversée pendant la transmission : au lieu de \(0110011\), nous recevons \(0110001\). Reprenons les trois contrôles. Le premier, sur 1, 3, 5 et 7, reste correct : il donne 0. Le deuxième, sur 2, 3, 6 et 7, est incorrect : il donne 1. Le troisième, sur 4, 5, 6 et 7, est lui aussi incorrect : il donne 1. Nous assemblons ces résultats dans l’ordre des poids 1, 2 et 4 : \[S=0\times1+1\times2+1\times4=6.\] Le nombre obtenu est précisément la position de l’erreur ! Il suffit d’inverser le sixième bit, puis de relire les données aux cases 3, 5, 6 et 7 pour retrouver \(1011\).
06:00–07:00Pourquoi sept bits suffisent pour une erreur
Une propriété remarquable apparaît. Il y a huit situations à distinguer : aucune erreur, ou une erreur en l’une des sept positions. Or trois contrôles binaires peuvent produire \(2^3=8\) résultats différents. Ils fournissent donc juste assez d’informations pour identifier l’emplacement de toute erreur unique. En langage des codes, deux messages valides du code de Hamming diffèrent en au moins trois positions : on dit que sa distance minimale vaut 3. Ainsi, si un mot reçu n’a subi qu’une seule modification, on peut retrouver sans ambiguïté le mot valide d’origine. En revanche, avec deux erreurs, l’algorithme simple pourrait corriger la mauvaise position : cette garantie ne concerne qu’une erreur au maximum.
07:00–08:00La probabilité permet de mesurer la fiabilité
Imaginons un canal fictif où chaque bit se trompe indépendamment avec probabilité \(p\). Pour un message de sept bits, le nombre d’erreurs \(X\) suit une loi binomiale de paramètres 7 et \(p\). Le code corrige systématiquement si zéro ou un seul bit a été modifié : \[P(X\le1)=(1-p)^7+7p(1-p)^6.\] Si \(p=0{,}01\), cette probabilité dépasse 99,79 %. Il s’agit d’une probabilité de correction garantie dans notre modèle de transmission indépendant, pas d’un taux de réussite universel du QR code. Ce calcul illustre l’intérêt de la redondance : quelques bits supplémentaires peuvent faire baisser fortement le risque qu’une erreur isolée rende un message inexploitable.
08:00–09:00Le vrai QR code utilise une idée plus puissante
Les QR codes modernes ne se contentent évidemment pas de sept bits. Ils organisent des données, des motifs de repérage, des contrôles et des symboles correcteurs. Pour la correction des données, ils utilisent des codes de Reed-Solomon, qui travaillent sur des octets, c’est-à-dire des groupes de huit bits. Le fabricant DENSO WAVE distingue quatre niveaux de correction, appelés L, M, Q et H, correspondant à des capacités approximatives de restauration de 7 %, 15 %, 25 % et 30 % des mots de code selon le niveau. Ces nombres ne promettent pas qu’on peut enlever librement la même proportion de surface : la localisation des dommages, les motifs de repérage et les réglages du lecteur comptent aussi.
09:00–10:00La redondance : une idée contre-intuitive
On pourrait penser qu’un message plus court est toujours préférable. Mais transmettre seulement les données utiles est fragile : une inversion suffit à changer l’information. Ajouter des contrôles augmente la longueur du message, donc le coût de stockage, mais rend possible la réparation de certaines erreurs. Tout l’enjeu est de choisir un compromis entre capacité et fiabilité. La grande idée de cette démonstration tient en une phrase : les mathématiques permettent d’encoder suffisamment d’informations supplémentaires pour déduire une partie de ce que l’on ne voit plus. Notre code de Hamming illustre cela avec des calculs élémentaires ; le QR code réel applique le même principe de redondance structurée avec des outils algébriques plus avancés. Et cette logique sert aussi aux communications, au stockage numérique et aux transmissions spatiales.