Exposé complet — environ 10 minutes
Ce texte constitue une trame orale rédigée, à comprendre et à s’approprier plutôt qu’à réciter mécaniquement. Les formules peuvent être montrées progressivement sur le support pendant la présentation.
00:00–01:00Introduction — l’intuition face aux chiffres
Imaginez qu’un ami revienne d’un dépistage : le laboratoire lui annonce un résultat positif. Il vous dit : « Le test est fiable à 99 %, donc je suis presque certainement malade. » Cette conclusion paraît naturelle, mais elle peut être complètement fausse. Le mot fiable cache plusieurs probabilités différentes. Pour le comprendre, je vais inventer une situation de dépistage. Les chiffres sont fictifs : je ne décris aucun test réel ni aucune maladie précise. Je suppose que la maladie touche 1 % des personnes dépistées, que le test détecte 99 % des malades et qu’il donne un résultat positif chez 5 % des personnes qui ne sont pas malades. Ma question sera : quelle est alors la probabilité d’être malade sachant que le test est positif ?
01:00–02:05Trois probabilités très différentes
Notons \(M\) l’événement « la personne est malade » et \(T\) l’événement « le résultat est positif ». Première information : la prévalence est \(P(M)=0{,}01\). Deuxième information : la sensibilité est \(P(T\mid M)=0{,}99\). Troisième information : la spécificité est \(P(\overline T\mid\overline M)=0{,}95\), donc \(P(T\mid\overline M)=0{,}05\). La confusion consiste à remplacer \(P(M\mid T)\) par \(P(T\mid M)\). Pourtant, ces deux probabilités conditionnelles ne posent pas la même question. L’une demande ce que fait le test quand on connaît l’état de santé ; l’autre cherche l’état de santé quand on connaît le résultat. Comme en géométrie, inverser une implication ne donne pas forcément une affirmation vraie.
02:05–03:15Choisir 10 000 personnes pour raisonner
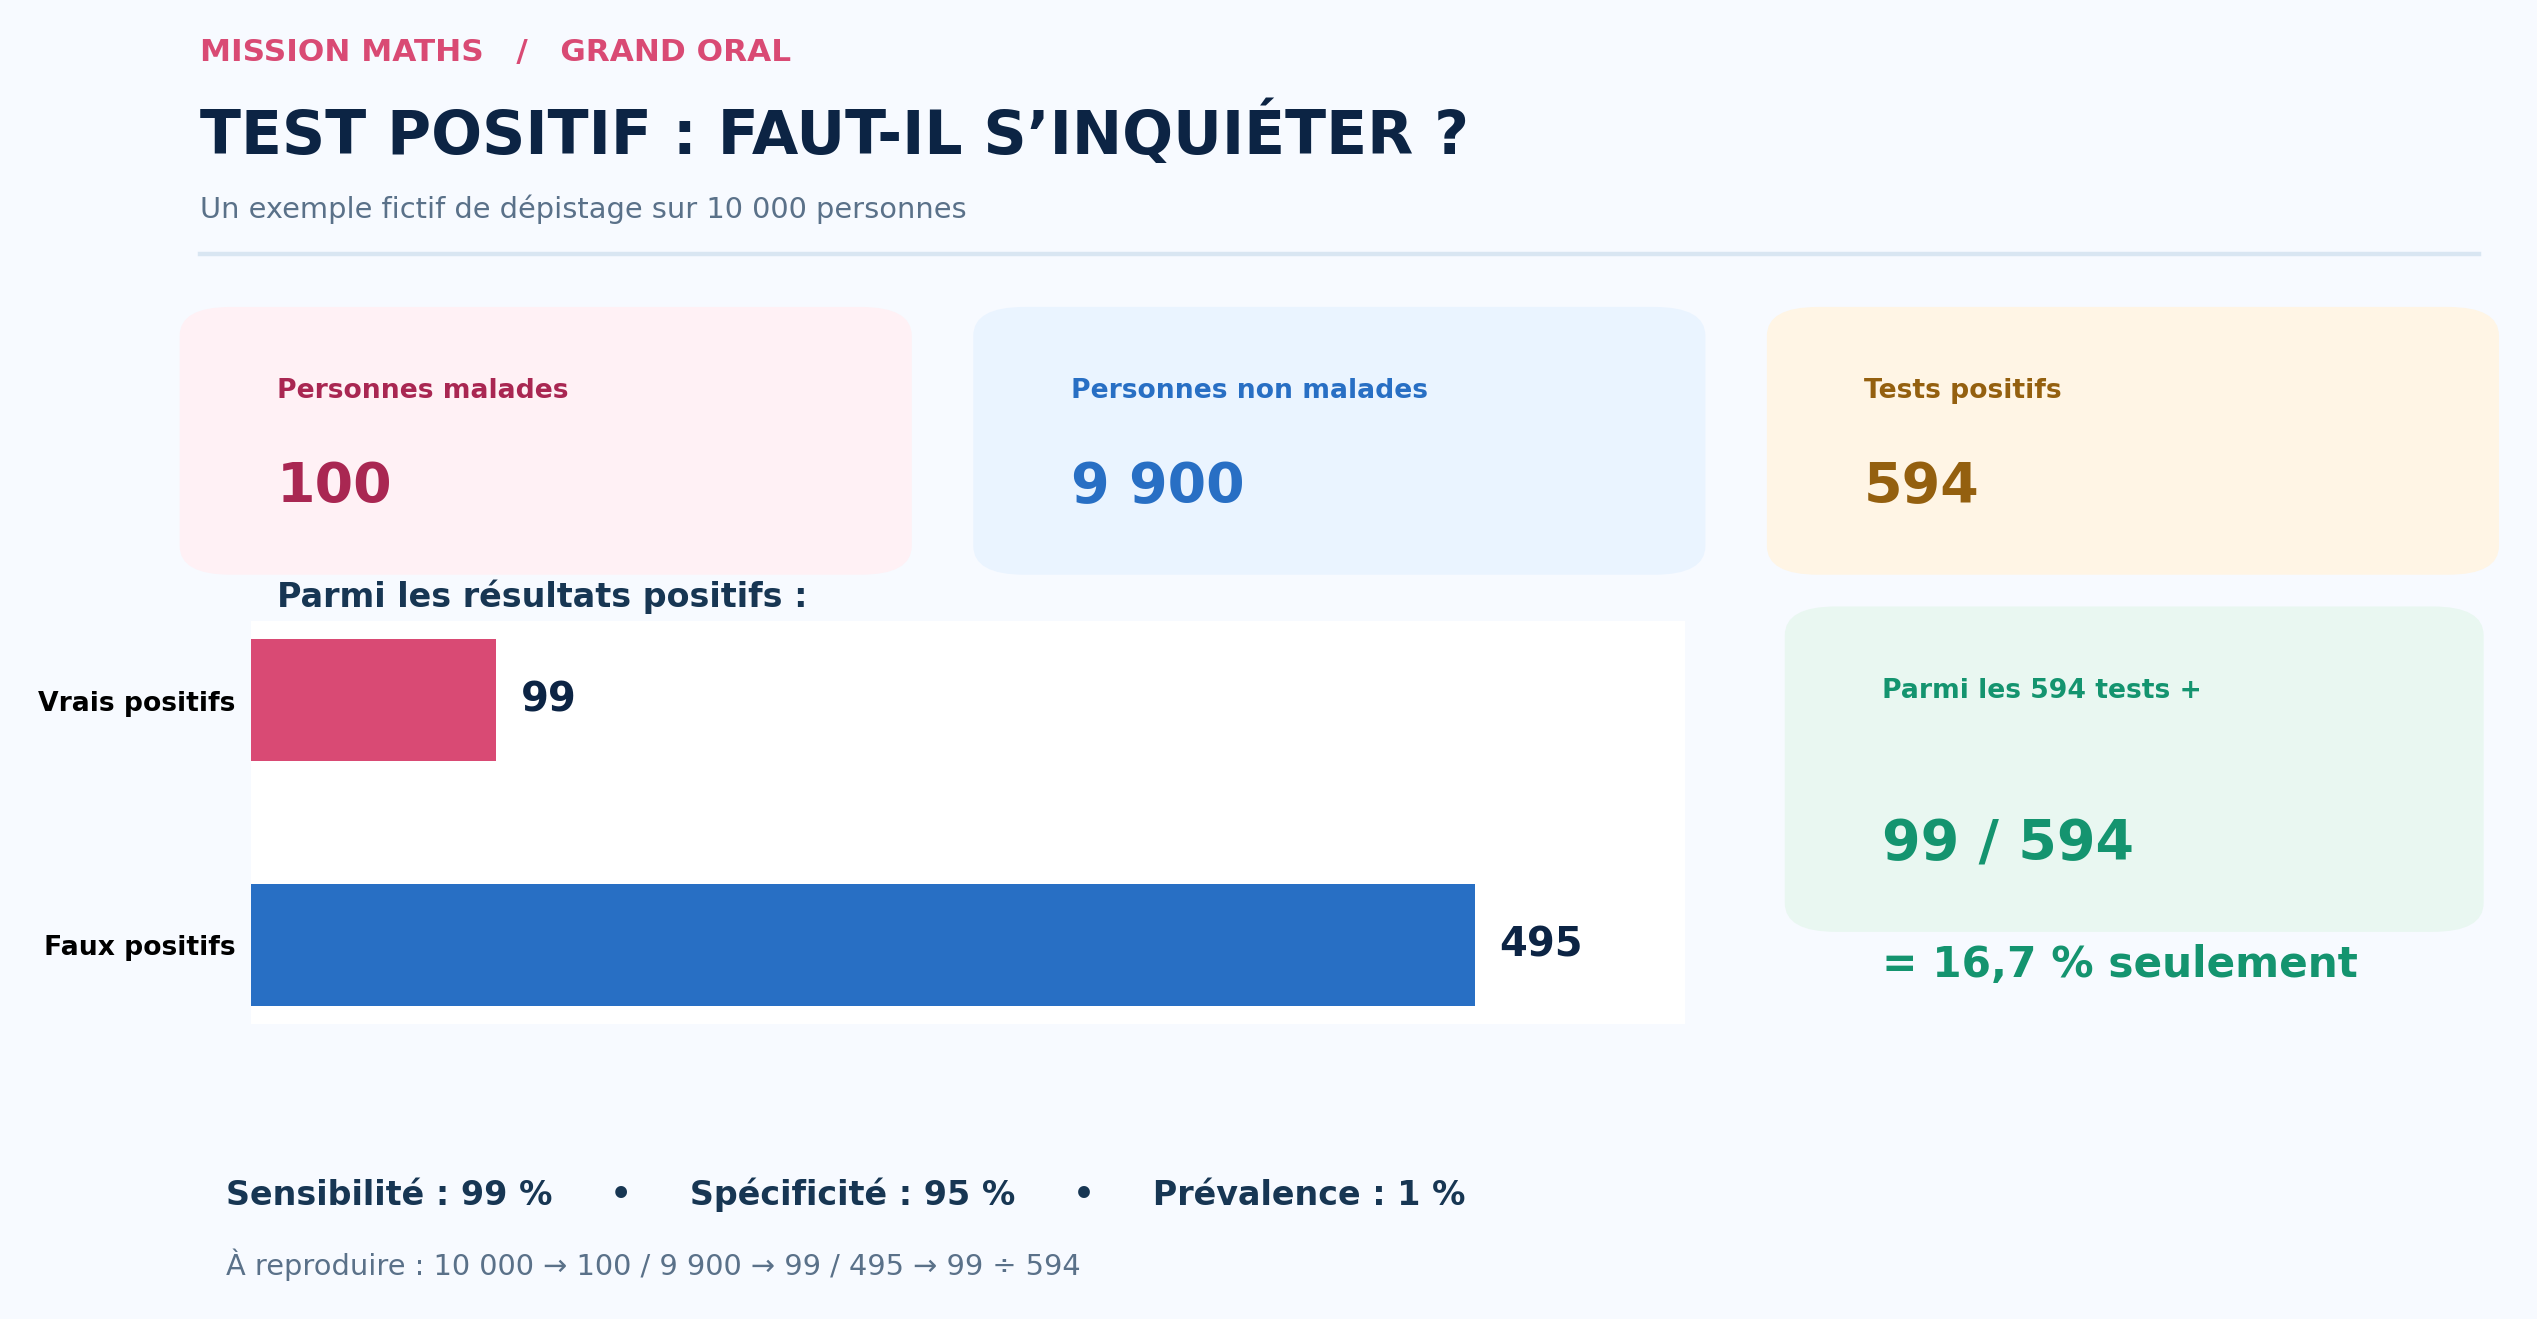
Plutôt que de commencer avec une formule abstraite, considérons une cohorte théorique de 10 000 personnes. Avec une prévalence de 1 %, 100 sont malades et 9 900 ne le sont pas. Parmi les 100 malades, la sensibilité de 99 % conduit à 99 tests positifs et un négatif. Parmi les 9 900 personnes non malades, le taux de faux positifs de 5 % conduit à 495 tests positifs et 9 405 négatifs. Il est important de dire « en moyenne » ou « effectifs attendus » si l’on imagine une population tirée au hasard : ici, ce tableau numérique est un modèle idéal. On constate déjà que les faux positifs, 495, sont beaucoup plus nombreux que les vrais positifs, 99.
03:15–04:20Le calcul qui surprend
Comptons tous les résultats positifs : \(99+495=594\). Parmi ces 594 résultats, seuls 99 concernent une personne malade. Par conséquent,
\[P(M\mid T)=\frac{99}{594}=\frac16\approx 16{,}7\,\%.\]
Autrement dit, dans cet exemple seulement, environ cinq résultats positifs sur six sont de fausses alertes. Ce résultat n’est pas une erreur du test : il vient du fait que les personnes en bonne santé sont 99 fois plus nombreuses que les personnes malades. Même un petit pourcentage de faux positifs appliqué à un grand groupe produit beaucoup de cas. Le résultat change dès que change la population dépistée : le chiffre de 16,7 % n’est pas une statistique médicale universelle.
04:20–05:25L’arbre pondéré et la formule générale
On peut reconstruire ce raisonnement avec l’arbre pondéré étudié en Terminale. Sa première séparation donne \(M\) de probabilité 0,01 et \(\overline M\) de probabilité 0,99. Puis on ajoute les résultats positifs avec les probabilités conditionnelles 0,99 et 0,05. La formule des probabilités totales donne
\[P(T)=0{,}01\times0{,}99+0{,}99\times0{,}05=0{,}0594.\]
La définition de la probabilité conditionnelle fournit
\[P(M\mid T)=\frac{P(M\cap T)}{P(T)}=\frac{0{,}0099}{0{,}0594}.\]
On retrouve exactement \(1/6\). Cette écriture est un cas particulier de la formule dite de Bayes : elle permet de mettre à jour une probabilité quand une nouvelle information arrive.
05:25–06:35Et si la maladie était plus fréquente ?
Une donnée essentielle est la prévalence, c’est-à-dire le risque initial dans le groupe concerné. Si je conservais la même sensibilité et la même spécificité mais que je dépistais une population où 10 % des personnes sont malades, alors
\[P(M\mid T)=\frac{0{,}10\times0{,}99}{0{,}10\times0{,}99+0{,}90\times0{,}05}=0{,}6875.\]
On passe donc de 16,7 % à 68,75 %, sans modifier le test lui-même. C’est ce qui rend si importante la population étudiée. Un test n’a pas une unique probabilité d’être « vrai après un positif » indépendante du contexte. Les critères du dépistage, les symptômes et les antécédents peuvent modifier la probabilité de départ.
06:35–07:45La loi binomiale et le nombre de fausses alertes
Passons d’un individu à une campagne de dépistage. Supposons que nous testions 9 900 personnes dont on sait, dans notre modèle, qu’elles sont non malades. Si les résultats sont indépendants et que chacune a 5 % de risque de faux positif, le nombre \(X\) de fausses alertes suit une loi binomiale :
\[X\sim\mathcal B(9900;0{,}05).\]
Son espérance est \(E(X)=9900\times0{,}05=495\). Sa variance est \(9900\times0{,}05\times0{,}95=470{,}25\), d’où un écart-type proche de 21,7. Les 495 faux positifs ne sont donc pas un résultat exact garanti à chaque dépistage : c’est le nombre moyen prédit par le modèle. Cette nuance relie les probabilités conditionnelles à la fluctuation d’échantillonnage.
07:45–08:55Deux tests successifs : une amélioration possible, pas automatique
On peut vouloir confirmer le premier résultat avec un second examen. Si, hypothèse très forte, les deux résultats étaient indépendants une fois l’état de santé fixé, et si les deux tests avaient la même sensibilité et spécificité, la probabilité d’obtenir deux positifs serait 0,99 au carré chez les malades et 0,05 au carré chez les non malades. En appliquant encore Bayes, on obtient environ 79,8 % de malades parmi les doubles positifs. La confirmation augmente donc la valeur de l’information. Mais, dans la réalité, deux examens peuvent commettre les mêmes erreurs ou dépendre des mêmes facteurs ; on ne doit pas supposer leur indépendance sans justification. Aucun calcul isolé ne remplace l’avis médical.
08:55–10:05Conclusion — ce que signifie vraiment « positif »
Ce problème enseigne une idée générale : une information n’a de sens qu’en tenant compte de ce qui était plausible avant de l’obtenir. Nous sommes partis d’un test sensible à 99 % et nous avons trouvé seulement 16,7 % de probabilité de maladie après un résultat positif dans une population fictive où la maladie est rare. Le secret n’est ni une formule magique ni un paradoxe : c’est la distinction entre deux probabilités conditionnelles. L’arbre pondéré explique le phénomène et la loi binomiale permet de penser les effectifs à grande échelle. Dans la vraie vie, le résultat d’un test doit être interprété avec son contexte, et il peut nécessiter d’autres examens. Les mathématiques ne posent pas le diagnostic : elles empêchent de confondre une alerte avec une certitude.