La problématique et les notions
Comment réduire le nombre moyen d’analyses nécessaires pour repérer des cas rares, tout en gardant l’objectif de tester individuellement les personnes des groupes positifs ?
Loi binomialeÉvénement contraireEspéranceFonctions et optimisationAlgorithmique
Exemple théorique : tests supposés parfaits, échantillons indépendants et prévalence connue. Dans la réalité, la dilution peut diminuer la sensibilité ; ce calcul ne constitue pas une recommandation médicale ou une stratégie de dépistage adaptée à toute situation.
Exposé complet — environ 10 minutes
Une trame orale à comprendre et à s’approprier. Les démonstrations sont proposées pour être présentées progressivement devant le jury.
00:00–01:001 000 personnes, 1 000 tests : est-ce inévitable ?
Imaginons que nous devions tester 1 000 personnes pour rechercher une infection rare. L’idée la plus évidente consiste à analyser chaque personne séparément : cela demande 1 000 analyses. Pourtant, en 1943, Robert Dorfman a étudié une autre stratégie, fondée sur les groupes. Pourquoi tester directement tout le monde si presque tous les résultats sont négatifs ? Nous allons examiner un modèle entièrement fictif : chaque personne a 1 % de probabilité d’être infectée, les personnes sont indépendantes, et les tests sont parfaits. Avec ces hypothèses, je vais montrer que la moyenne du nombre d’analyses peut tomber autour de 196. La méthode ne devine pas qui est malade : elle change simplement l’ordre dans lequel on cherche l’information.
01:00–02:00Le principe des mélanges d’échantillons
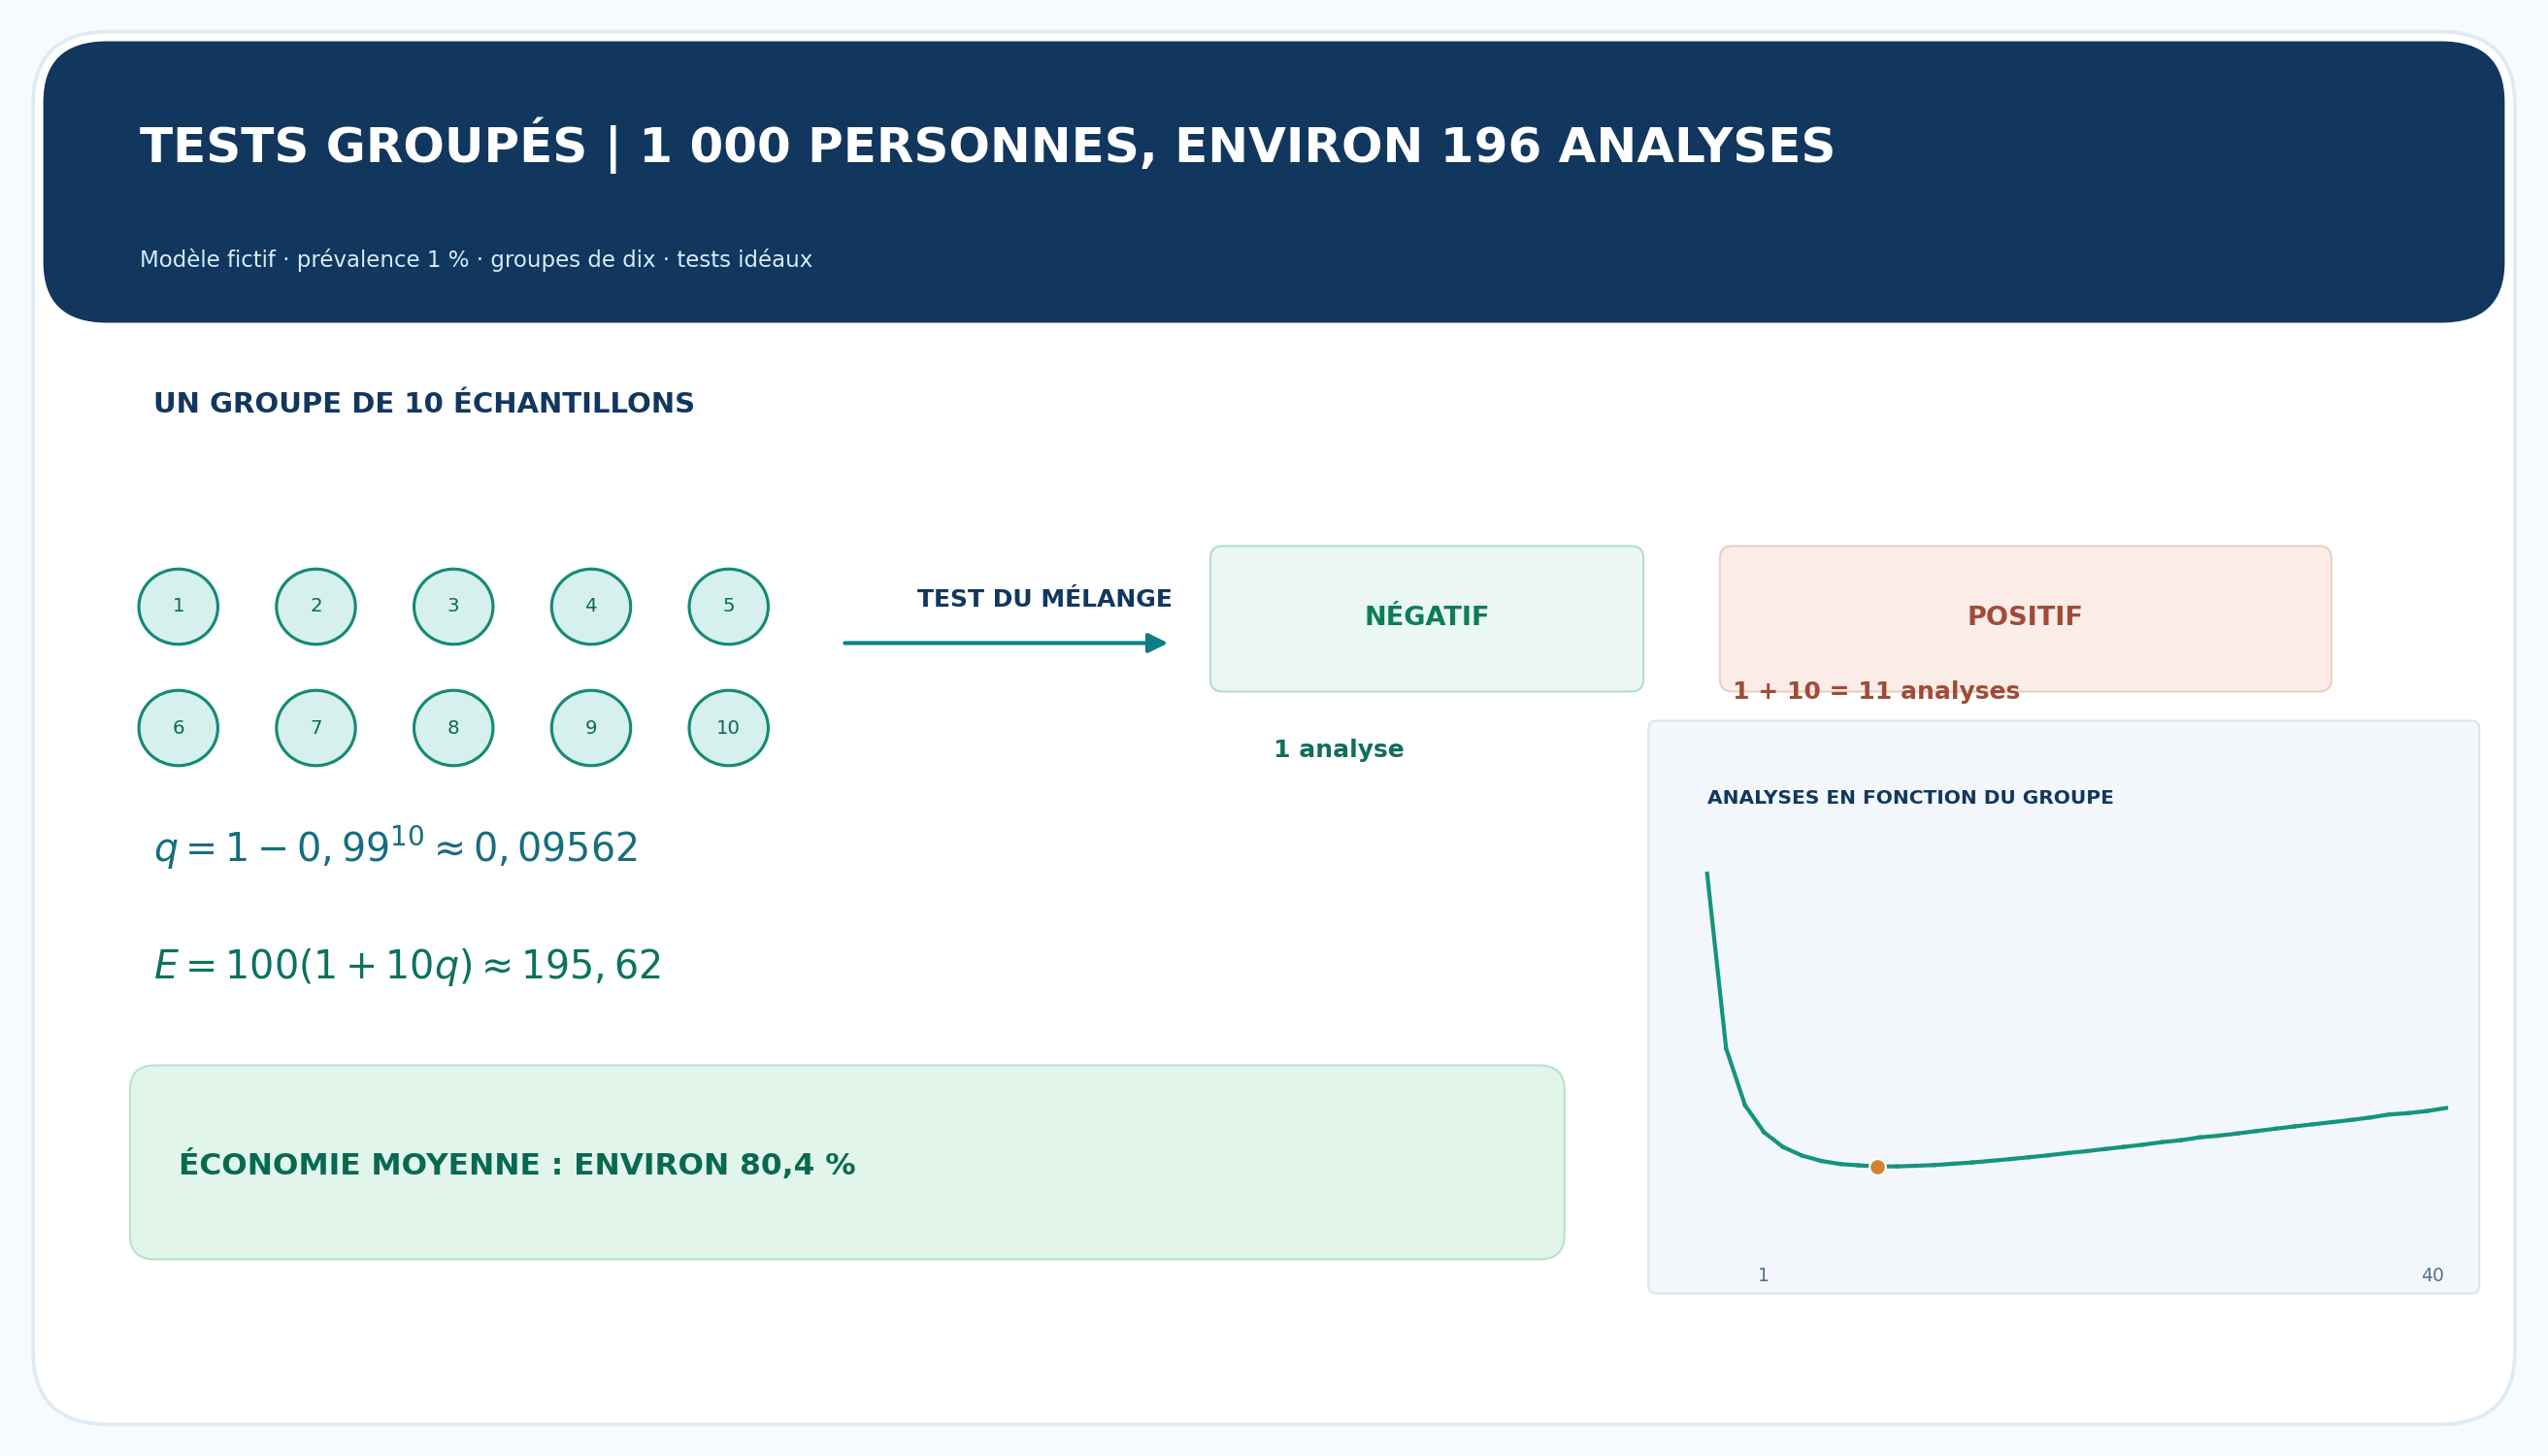
Au lieu de tester chacun des 1 000 prélèvements séparément, nous les divisons en 100 groupes de dix. Pour chaque groupe, nous mélangeons une petite partie des dix échantillons et réalisons une première analyse collective. Si ce mélange est négatif, les dix personnes du groupe sont supposées négatives : une seule analyse a suffi. Si le mélange est positif, nous devons identifier les personnes concernées et procédons alors à dix nouvelles analyses individuelles. Un groupe demande donc soit une analyse, soit onze analyses. Cela paraît parfois plus coûteux que dix ! Mais quand l’infection est rare, les groupes positifs sont peu nombreux, et la majorité des groupes ne nécessitent qu’un seul test. C’est un pari que l’espérance mathématique permet de chiffrer.
02:00–03:00Une loi binomiale cachée dans chaque groupe
Notons \(X\) le nombre de personnes infectées dans un groupe de dix. Avec nos hypothèses — indépendance, deux issues, probabilité \(p=0{,}01\) identique et nombre de personnes fixé — nous pouvons écrire \[X\sim\mathcal B(10;0{,}01).\] Un groupe est négatif exactement quand \(X=0\). Grâce à la loi binomiale, \[P(X=0)=(1-0{,}01)^{10}=0{,}99^{10}\approx0{,}904382.\] La probabilité d’un groupe positif est donc \[q=P(X\ge1)=1-0{,}99^{10}\approx0{,}095618.\] Ainsi, dans ce modèle, un groupe de dix a seulement environ 9,56 % de chances de nécessiter des analyses individuelles supplémentaires. Le point fondamental est l’utilisation de l’événement contraire : calculer « au moins un positif » devient beaucoup plus simple en calculant « aucun positif ».
03:00–04:00Le calcul décisif : 1,956 analyse par groupe
Appelons \(T\) le nombre d’analyses réalisées pour un groupe. Si le groupe est négatif, \(T=1\). S’il est positif, \(T=11\), puisque nous avons déjà effectué le test collectif puis nous retestons les dix personnes. L’espérance se calcule donc ainsi : \[E(T)=1\times(1-q)+11\times q=1+10q.\] Avec \(q=1-0{,}99^{10}\), cela donne \[E(T)=1+10(1-0{,}99^{10})\approx1{,}956179.\] En moyenne, un groupe de dix coûte donc un peu moins de deux analyses. Pour les 100 groupes, la linéarité de l’espérance fournit \[\boxed{E(T_{\mathrm{total}})=100E(T)\approx195{,}62.}\] Voilà les quelque 196 analyses annoncées au début. Ce nombre n’est pas un total certain : c’est une moyenne théorique.
04:00–05:00D’où vient une économie supérieure à 80 % ?
Le dépistage individuel demande exactement 1 000 analyses. Notre méthode en demande 195,62 en moyenne. L’économie attendue est donc d’environ \[1000-195{,}62=804{,}38\text{ analyses},\] soit \[\boxed{100\left(1-\frac{195{,}62}{1000}\right)\approx80{,}4\%}.\] Ce résultat est possible parce qu’un groupe négatif efface dix possibilités d’un seul coup. Toutefois, il reste aléatoire : une série comportant beaucoup de groupes positifs nécessitera davantage d’analyses que la moyenne. On peut même observer le nombre de groupes positifs, noté \(Y\), qui suit ici la loi \(\mathcal B(100;q)\). Le total prend alors la forme \[T_{\mathrm{total}}=100+10Y.\] La loi binomiale ne sert donc pas seulement à obtenir une moyenne : elle permet aussi d’étudier les fluctuations.
05:00–06:00Faut-il créer des groupes encore plus grands ?
Un groupe de 20 personnes paraît encore plus avantageux au premier regard : il faut seulement 50 tests collectifs pour 1 000 personnes. Mais il a aussi davantage de chances de contenir au moins un cas positif ; chaque groupe positif demandera 20 analyses supplémentaires. Il existe donc un compromis entre le nombre de groupes et le coût d’un résultat positif. Pour \(N\) personnes et des groupes de taille \(g\) lorsque \(g\) divise \(N\), la formule générale devient \[\boxed{E_g=\frac Ng+N\left[1-(1-p)^g\right].}\] Le premier terme décroît quand on agrandit les groupes ; le second augmente. C’est exactement le genre de situation où chercher un minimum a un sens concret.
06:00–07:00Optimiser la taille des groupes
Pour une faible prévalence, on peut approximer \(1-(1-p)^g\) par \(gp\), à condition que \(gp\) reste suffisamment petit. Le nombre d’analyses par personne devient alors voisin de \[f(g)=\frac1g+gp.\] Regardons \(g\) comme une variable réelle positive. Sa dérivée est \[f'(g)=-\frac1{g^2}+p.\] Elle s’annule lorsque \(g=1/\sqrt p\). Si \(p=0{,}01\), cette estimation suggère \(g\approx10\). Une comparaison numérique de la formule exacte pour \(N=1000\) et toutes les tailles possibles, y compris un dernier groupe plus petit, place le minimum autour de onze personnes par groupe. Ce calcul rapproche donc la loi binomiale, la dérivation et l’algorithmique d’une véritable décision d’organisation.
07:00–08:00Pourquoi la fréquence réelle varie autour de la moyenne
Si nous réalisons effectivement une campagne fictive, le total d’analyses pourrait être 170, 200 ou 230 : la valeur 195,62 n’est pas une prédiction exacte d’une campagne isolée. En comptant les groupes positifs, \(Y\sim\mathcal B(100;q)\), nous obtenons \[E(Y)=100q\approx9{,}56.\] Le nombre total d’analyses est \(100+10Y\), d’où \[V(T_{\mathrm{total}})=100q(1-q)\times10^2.\] Cet écart entre espérance et observation constitue aussi une occasion d’expliquer ce que mesure une loi de probabilité. Une simulation informatique répétant des campagnes de 1 000 personnes doit faire apparaître des totaux fluctuants, tout en retrouvant un ordre de grandeur moyen proche de notre calcul.
08:00–09:00Une hypothèse délicate : les tests doivent rester fiables
Il serait dangereux de conclure qu’il faut toujours mélanger des prélèvements. Dans la réalité, le fait de diluer un échantillon positif dans plusieurs négatifs peut rendre sa détection plus difficile ; les tests ne sont pas parfaits, et les individus ne sont pas toujours indépendants. L’organisation du laboratoire, les délais, les coûts d’un nouveau prélèvement et la proportion de personnes atteintes modifient également l’intérêt de la méthode. La stratégie de Dorfman fournit une belle démonstration mathématique, pas une consigne médicale universelle. Elle est surtout intéressante quand la prévalence est faible et que la technique de laboratoire a été validée pour ce type de regroupement. Sans ces précautions, économiser des tests pourrait se faire au détriment de l’objectif essentiel : détecter correctement les cas.
09:00–10:00Prendre de meilleures décisions avec les probabilités
Pour conclure, notre question était : peut-on tester 1 000 personnes avec beaucoup moins de 1 000 analyses ? Dans un modèle fictif où 1 % des personnes sont positives et où les tests groupés sont parfaits, la réponse est oui : dix échantillons réunis, puis un retest individuel des groupes positifs, demandent environ 196 analyses en moyenne. L’outil mathématique central est l’espérance d’une variable aléatoire, complétée par une loi binomiale et par l’optimisation d’une fonction. Ce sujet montre une idée plus large : une opération apparemment incontournable peut souvent être remplacée par une stratégie intelligente d’acquisition de l’information. Mais les limites du modèle sont aussi importantes que son résultat. Les maths n’imposent pas une décision ; elles permettent de comprendre quand une décision est raisonnable.